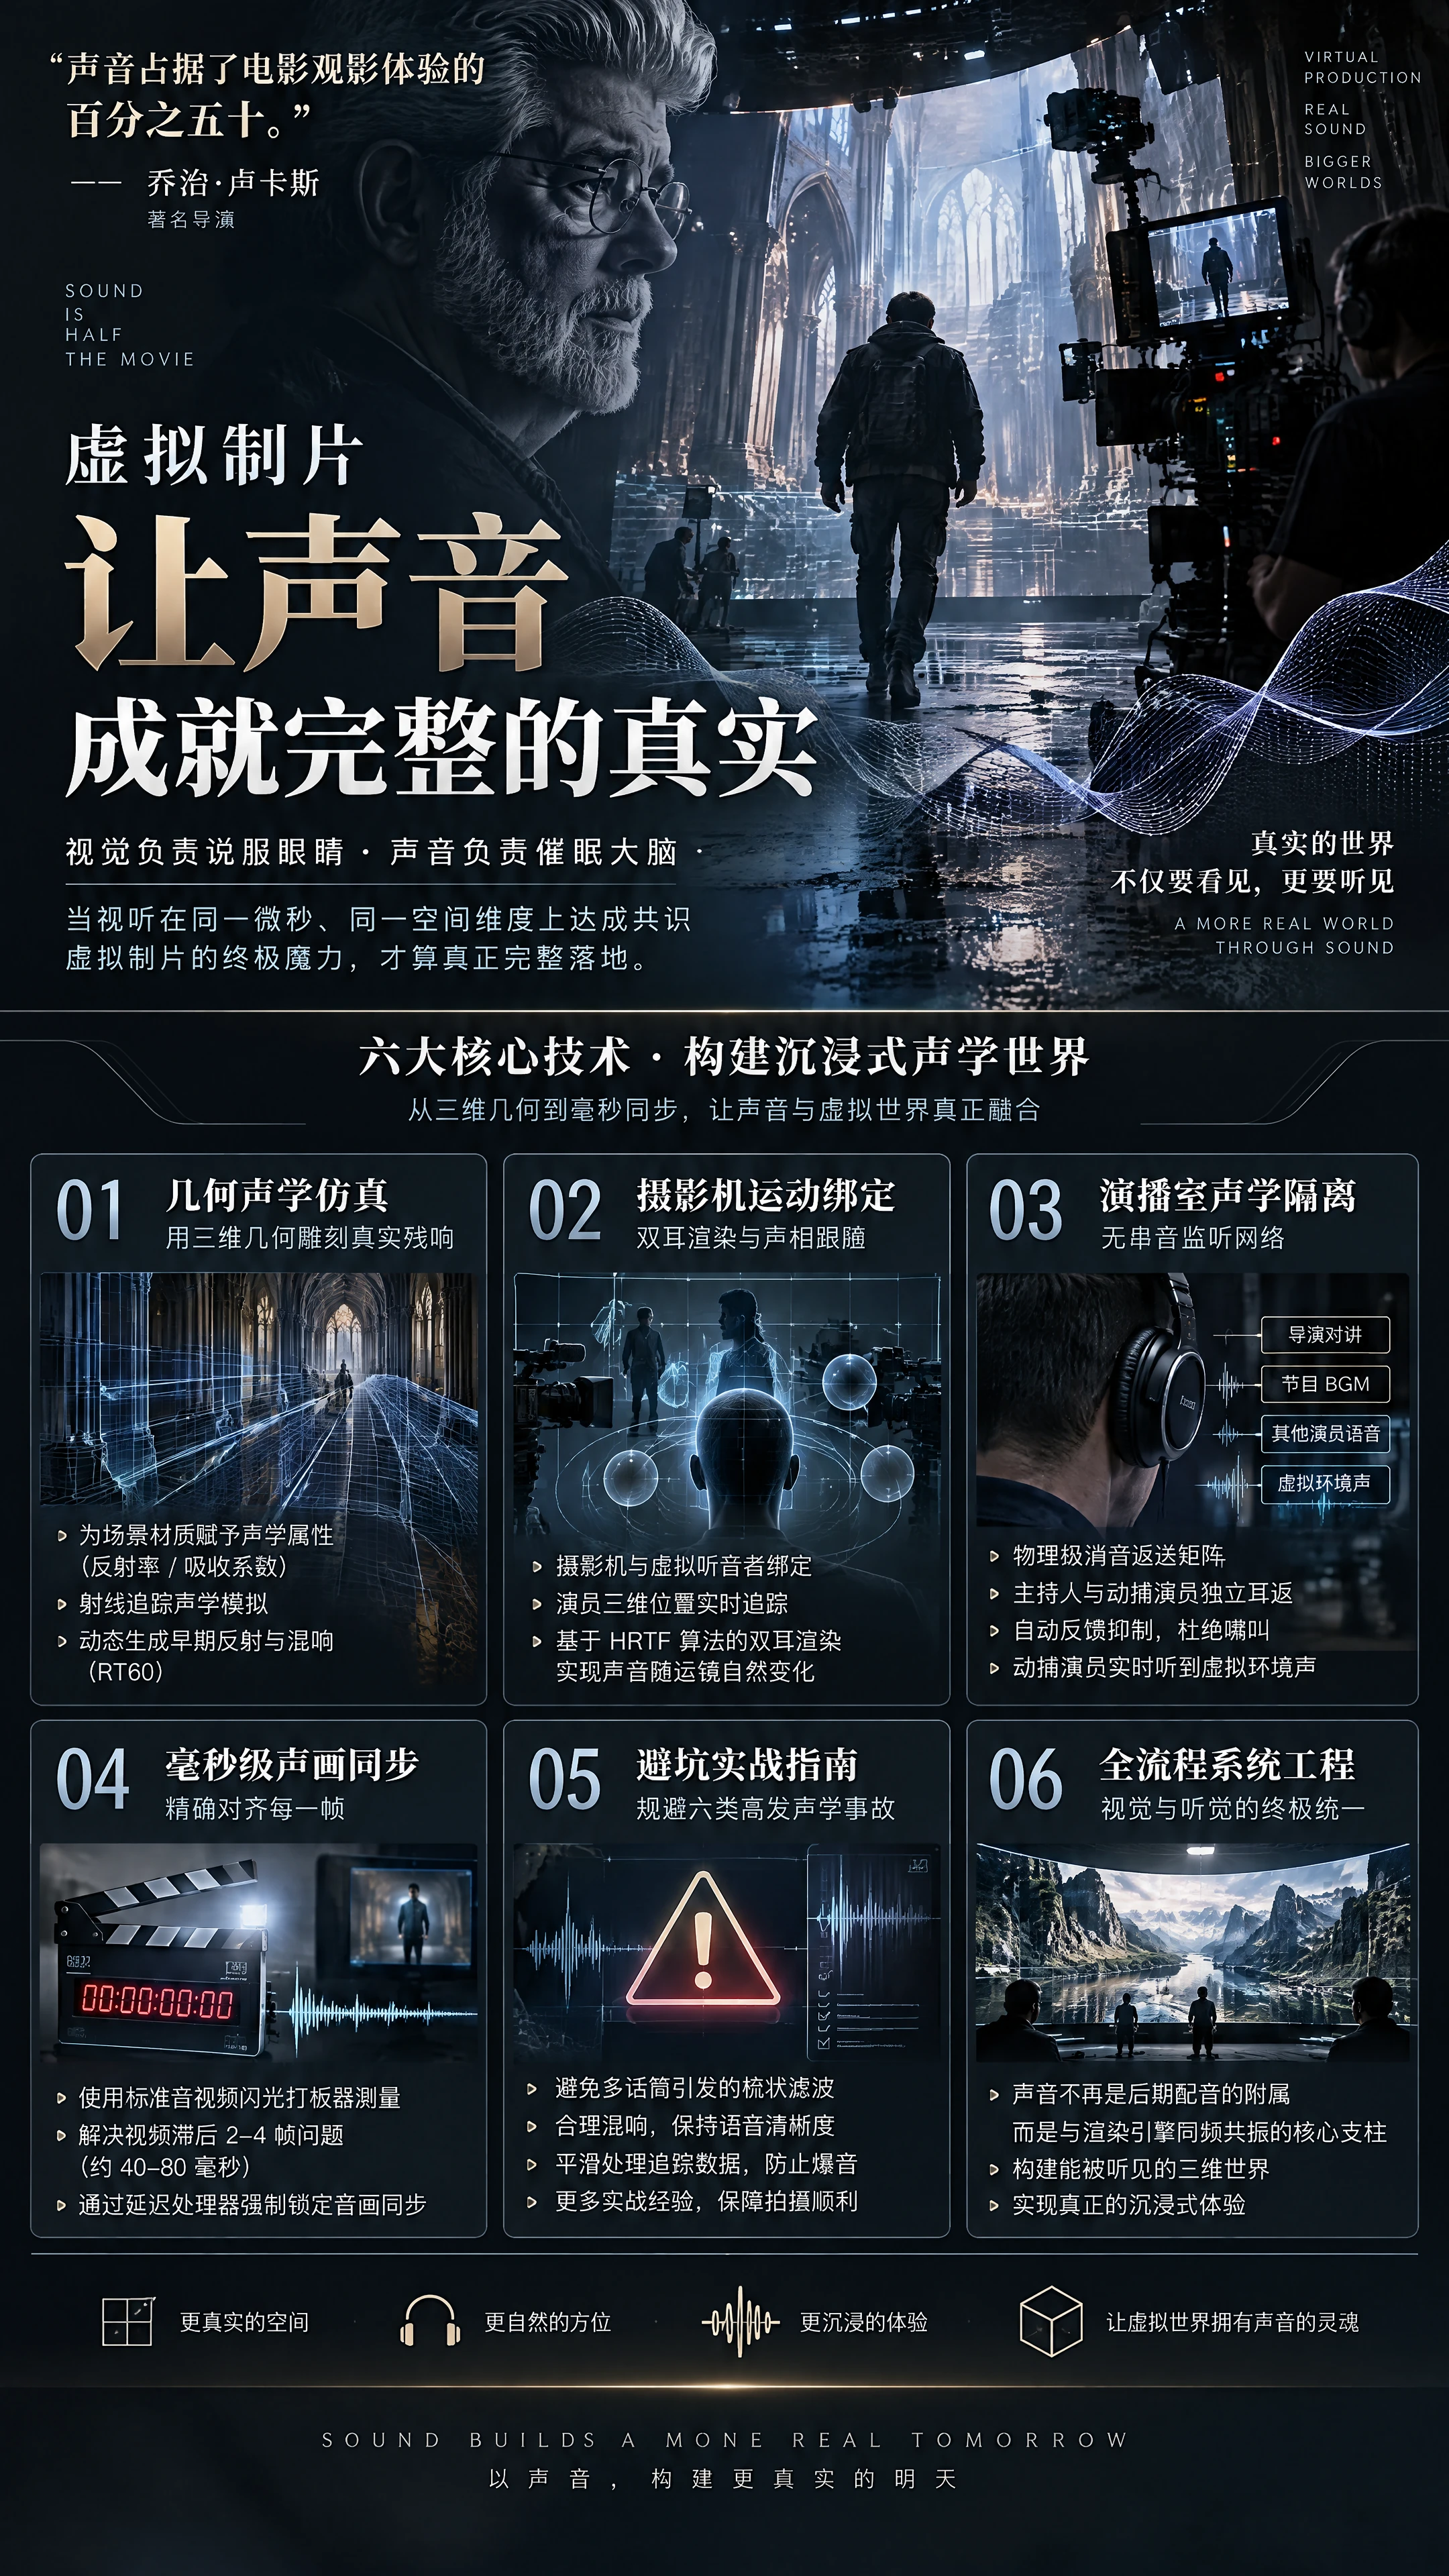
著名导演乔治·卢卡斯曾指出:“声音占据了电影观影体验的百分之五十。”然而,在当下的虚拟制片热潮中,绝大多数团队的注意力被牢牢锁死在视觉维度——显卡买了顶配、屏幕点间距缩到了最小、色彩管理标定到了微米级。但在成片播放的一瞬间,观众依然会产生难以名状的违和感:画面上演员正冒雨穿行在空旷的废弃厂房中,传出来的声音却干瘪无力,宛如在播音室里录制的电话语音;演员从远处向镜头走来,脚步声的声学衰减曲线与画面的空间景深毫无逻辑关联。视觉负责说服眼睛,声音负责催眠大脑。如果听觉信息没有与虚拟三维空间完成几何级的声学绑定,所谓“沉浸感”便只是一张经不起推敲的半成品。本文将从几何声学仿真、追踪驱动的动态声相、多通道无串音监听网络到纳秒级声画同步,全面揭开虚拟制片音频工程的终极秘密。
一、 视听剥离:传统演播室音频在虚拟环境中的三大破绽
想要重塑真实感,必须先看清传统线性音频工作流在虚拟世界中的致命脱节:
第一是“声学环境特征的精神分裂”。 物理演播室为了保证录音清晰度,通常进行了重度声学吸音处理,混响时间(RT60)被压制在 0.2 秒以内的极干状态。当演员置身于一个用 UE5 渲染的欧式大教堂、地下防空洞或玻璃幕墙会议室时,眼睛看到的是长达 2 到 4 秒的物理声波反射场,耳朵听到的却是毫无混响的干音。这种视听感知失调(Cognitive Dissonance)会瞬间在观众脑海中敲响假象的警钟。
第二是“声相定位与摄影机透视的彻底脱钩”。 在传统影视拍摄中,吊杆话筒始终跟随演员移动,声相通常居中;但在虚拟制片中,摄影机的运镜自由度被彻底释放。当摄影机围绕两位对话的演员做 360 度环绕运镜时,如果左右声道的立体声位置依然静止不动,观众的方位感知系统就会彻底崩溃——眼睛看着人物转到了画面左侧,耳朵里他的声音却依然死死焊在右声道。
第三是“动态遮挡与空气吸收效应的缺失”。 在现实世界中,声波遇到墙壁、柱子或车辆时会发生绕射与高频吸收阻挡;在不同距离下,空气湿度还会对 4kHz 以上的高频产生渐进式衰减。虚拟制片中如果仅做简单的音量推拉,而没有根据虚拟三维资产的物理遮挡动态滤波,声音就会显得轻浮无质感。
二、 虚幻引擎物理声学仿真:用三维几何雕刻真实残响
解决“环境声学分裂”的根本手段,是将音频处理从静态的插件贴片,升级为“由三维场景几何驱动的动态声学计算”。
- 声学材质属性赋值 在 UE5 中构建虚拟场景时,绝不能只给模型赋予视觉材质。 • 物理阻尼与吸收系数:通过 Unreal Audio Engine 或第三方声学仿真中间件,为场景中的不同表面定义物理声学材质。 • 物理特性参数:大理石与混凝土赋予高达 0.95 的高反射率;木质家具与布艺沙发赋予吸收中高频的多孔吸声特性;水面与玻璃则赋予锐利的早期反射特性。
- 射线追踪声学模拟 在场景中以麦克风监听点和发声主体为原点,实时向四周空间发射数百条虚拟音频光线。 • 计算早期反射:根据光线碰撞到虚拟墙壁的距离与材质,在数毫秒内动态计算出反射声波的到达时间与方位角; • 动态生成晚期混响:当演员从狭窄的走廊步入开阔的大厅时,射线探测到的空间体积瞬间暴涨,引擎底层自动平滑插值调整混响时间(RT60)与频响曲线,无需录音师手动推拉调音台,让声音的空间质感与视觉运镜实现毫秒级物理自洽。
三、 摄影机运动绑定的双耳听觉渲染与声相跟随
在追求极致体验的高端制作中,声音不仅要有环境感,还要具备与摄影机镜头绝对咬合的动态空间感。
- 空间坐标数据注入音频引擎 追踪系统不仅要将摄影机的六自由度坐标发送给渲染主机,更要通过网络开放声音控制协议(OSC)以并联方式同步注入音频工作站。 • 监听视角与镜头绑定:在声学引擎中将“虚拟听音者”精确绑定在摄影机传感器的成像原点上; • 声源点与演员追踪绑定:在演员身上隐藏佩戴超宽带(UWB)微型定位标签,或通过光学动捕跟踪其头部物理坐标,将实时位置映射为三维虚拟声源点。
- 头部相关变换函数(HRTF)与双耳渲染 当实拍摄影机进行大幅度推拉摇移、侧向穿梭或环绕旋转时: • 系统根据演员声源点与摄影机监听点的相对三维矢量差,通过 HRTF 算法实时运算声音到达双耳的时间差与强度差; • 无论观众佩戴普通立体声耳机还是置身于多声道影院,都能清晰感知到声音随着运镜轨迹在三维空间中产生自然的近大远小、左右穿梭与方位轮转。
四、 演播室声学防串音隔离与无啸叫监听网络
虚拟制片演播室往往是高密度的声电交汇场,多路麦克风与现场监听极易引发灾难性的声学回路与高频啸叫。
- 物理级消音返送矩阵 在演播室中,导演调度指令、现场真人主持音频、动捕演员声音、虚拟场景音效与背景音乐必须走严格隔离的母线架构: • 主持人专属耳返:混入导演对讲音、节目 BGM 与动捕演员语音,强制剥离主持人自身麦克风信号; • 动捕演员专属耳返:混入导演对讲音、BGM 与现场主持人语音,强制剥离动捕演员自身麦克风信号; • 现场音箱扩音管理:在追求身临其境的沉浸式演出中,现场扬声器绝对严禁直对演员麦克风拾音轴向。必须采用超心型指向性头戴麦克风,配合自动声学反馈抑制器,将潜在的啸叫频点以极窄的陷波滤除。
- 虚拟演员的环境声真实返送 很多动捕演员在绿幕隔音舱内表演时情绪平淡,根源在于他们听不到自己“身处环境”的声学反馈。 • 进阶操作:将 UE5 实时计算出的动态声学混响,经过零延迟 DSP 处理器实时返送给动捕演员的入耳式耳机中。当中之人听到自己的声音在“山谷中回荡”或在“教堂中延绵”时,其声音的语气强弱、语速节奏会自动随着声学空间做出最本能的艺术调整,使表演张力成倍释放。
五、 毫秒级声画同步锁相体系
在虚拟制片系统中,声音信号走物理模拟链路处理速度极快(通常仅需几毫秒),而视频信号经过采集、渲染与合成,存在数帧的固有延迟。声画不同步是导致成片劣质的最隐秘杀手。
- 工业级音画时延测量法 切忌靠肉眼和耳朵去估摸延时!必须使用标准的音视频闪光打板器: • 在摄影机与麦克风前拍击打板器,打板器在闭合的瞬间同时发出高频蜂鸣声并点亮高亮 LED; • 在最终合成录制的工程文件中放大时间线,观察音频波形瞬态跳变起始点,与视频画面中 LED 灯光点亮的最早帧; • 记录两者之间的毫秒差值。
- 硬件与软件双重延时队列对齐 通常情况下,视频信号比音频信号慢 2 到 4 帧(约 40 至 80 毫秒)。 • 解决准则:在总控数字调音台的主输出通道与所有监听返送母线上,整体挂载精准的延迟处理器; • 强制锁定:将音频信号强制延时对应毫秒数,确保当演员嘴唇闭合的第一帧,发出的爆破音波形正好撞击在时间线的同一垂直线上。
六、 实战避坑清单:六类高发声学事故
- 演员走动时人声忽大忽小,且伴有空洞的金属相位声 • 根因分析:现场使用了多支固定吊杆话筒拾音,当演员走至两支话筒覆盖交叉区时,声波到达两支话筒微小的微秒时差引发了严重的梳状滤波抵消。 • 解决对策:虚拟制片中坚决禁用多固定话筒拾音,必须全员采用高品质腰包式无线胸麦或超微型头戴麦克风,保证单人拾音源的唯一性与距离恒定。
- 虚拟场景加了混响后,人声浑浊发糊,听不清台词细节 • 根因分析:混响器吃满了全频段信号,低频能量在虚拟空间中过度驻留膨胀。 • 解决对策:在送入混响总线前,对音频信号施加低切滤波(切除 120Hz 以下泥泞声),并对 3kHz 左右的语音清晰度频段进行轻微动态提升,让直达声始终扎实靠前,混响声仅作为背景烘托。
- 摄影机大幅度运镜时,耳机内传来剧烈的咔哒爆音 • 根因分析:空间音频引擎接收的 OSC 追踪数据包刷新率不均匀,导致空间声相插值算法发生除零断裂或坐标突跳。 • 解决对策:在音频中间件中对传入的摄像机坐标开启轻量级平滑滤波,限制坐标每毫秒的最大变动阈值,平滑抹除网络抖动毛刺。
七、 总结
虚拟制片绝不仅是一场关于视觉欺骗的技术革命,它是一场旨在构建全息感知世界的系统工程。一堵逼真的三维墙壁,不仅要能在镜头前反射正确的光子,更要能在声波撞击其表面时弹射出符合物理常理的残响;一个具有灵魂的虚拟角色,不仅要有生动的微表情,更要有与其实体空间分毫不差的声场辐射。
把声音从后期配音的附属地位,解放为拍摄现场与渲染引擎同频共振的核心支柱;让声波在虚拟几何构筑的殿堂里激荡出真实的空气质感。唯有当眼睛与耳朵在同一微秒、同一空间维度上达成无缝共识,虚拟制片的终极魔力才算真正完整落地。
 简体中文
 English