在虚拟制片与商业直播领域,最让导播窒息的噩梦莫过于:百万观众正在围观新品发布,渲染主机突然蓝屏,或者显卡因为过热触发驱动保护。对于普通直播,卡几秒可能只是槽点,但在千万级曝光的品牌活动中,这几秒钟就是严重的公关灾难。优秀的系统架构设计,绝不假设系统永远在线,而是预设它会在最关键的时刻宕机,并在此前提下构建出一套在宕机时观众毫无察觉的容灾体系。从硬件级的信号矩阵倒换,到引擎级的同步快照镜像,本文将为你揭示如何为虚拟演播室装上“最后一道安全气囊”。
一、 直播容灾的核心逻辑:硬件、数据、路由的三位一体
虚拟演播室的应急切换,绝非手动重启电脑那么简单,它必须在硬件路由、渲染算力与数据流转三个层面实现“实时对等”。
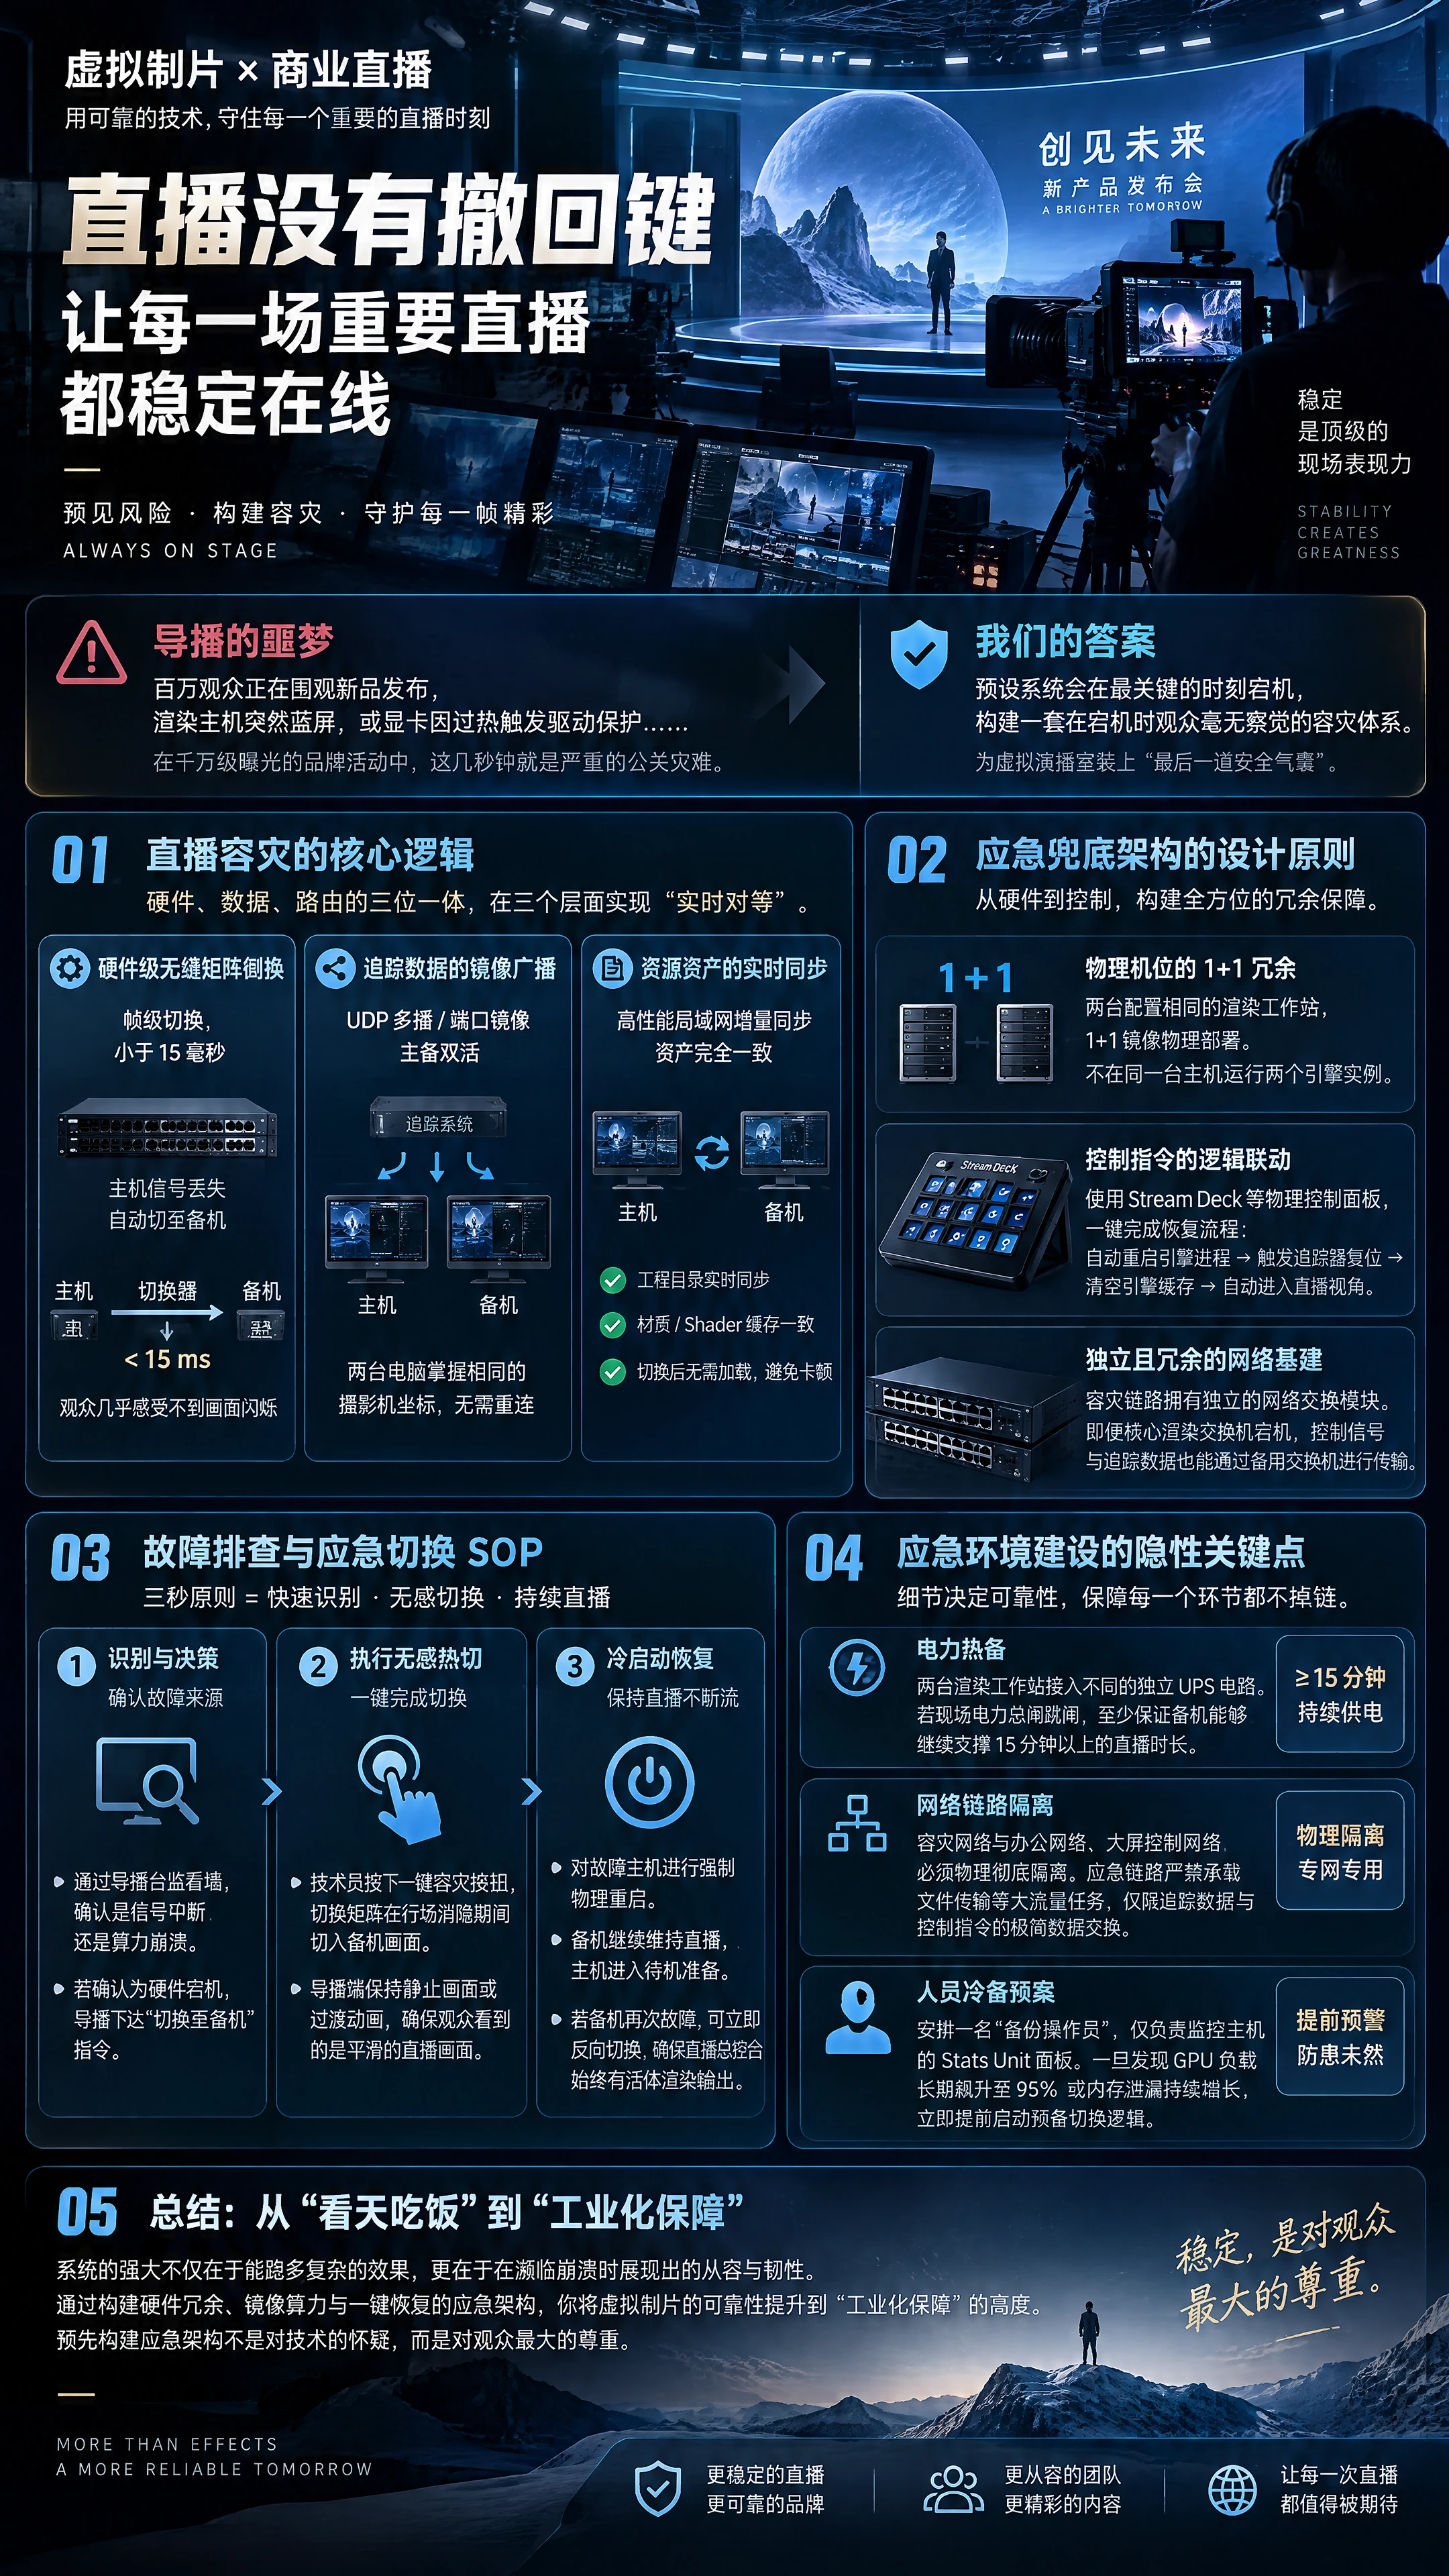
- 硬件级无缝矩阵倒换 这是防死机的最后一道防线。核心视频输出链路严禁直接接入流媒体编码器,必须先接入一台支持“帧级(Frame-accurate)倒换”的切换器或广播级矩阵。该设备实时监控主机(Master)的 SDI 信号。一旦检测到信号丢失,设备必须能在行场消隐期间(小于 15 毫秒)自动将输出源切至备机(Slave)。观众肉眼甚至感受不到画面的闪烁。
- 追踪数据的镜像广播 追踪系统(如 VIVE Mars / Mo-Sys)发送的 UDP 数据包必须配置为多播(Multicast)模式,或通过交换机端口镜像实时拷贝到主备两台渲染工作站。这意味着两台电脑看到的不是“主从关系”,而是“双活状态”。无论谁宕机,剩下的那一台都掌握着当前瞬间准确的摄影机坐标,无需任何逻辑重连,直接无缝承接。
- 资源资产的实时同步 主备工作站上的工程目录必须通过高性能局域网同步工具实现增量同步。在开机前,必须确保两台机器加载的资产材质、Shader 缓存完全一致,避免切换后备机加载资产导致卡顿。
二、 应急兜底架构的设计原则
- 物理机位的 1+1 冗余 不要试图在同一台渲染主机内运行两个引擎实例,那不仅不能容灾,反而会因为抢占 CPU/GPU 资源而导致两败俱伤。必须准备两台配置完全相同的渲染工作站,采用 1+1 镜像物理部署。
- 控制指令的逻辑联动 使用 Stream Deck 等物理控制面板,将所有的恢复逻辑固化为宏指令。通过简单的 API 调用,一键完成:自动重启引擎进程 -> 触发追踪器复位 -> 清空引擎缓存 -> 自动进入直播视角。不要让技术员在惊慌中用鼠标翻找文件夹和设置。
- 独立且冗余的网络基建 容灾链路必须拥有独立的网络交换模块。即便核心渲染交换机宕机,控制信号与追踪数据也必须能通过独立的备用交换机进行传输。
三、 故障排查与应急切换 SOP
当直播现场突发故障时,必须遵循以下“三秒原则”:
第一步:识别与决策 通过导播台监看墙,确认故障来源是信号中断还是算力崩溃。若确认为硬件宕机,导播下达“切换至备机”指令。
第二步:执行无感热切 技术员按下一键容灾按钮,切换矩阵在行场消隐期间切入备机画面。同时,导播在推流端保持静止画面或过渡动画,确保观众在切换瞬间看到的不是错误提示,而是相对平滑的直播中画面。
第三步:冷启动恢复 在保持直播不断流的前提下,对故障主机进行强制物理重启。冷启动后,备机继续维持直播,主机进入待机准备。若备机再次故障,可立即通过同样的倒换机制反向切换,确保直播总控台始终有活体渲染输出。
四、 应急环境建设的隐性关键点
- 电力热备 两台渲染工作站必须接入不同的独立 UPS 电路。若现场电力总闸发生跳闸,至少保证备机能够通过独立 UPS 继续支撑 15 分钟以上的直播时长。
- 网络链路隔离 容灾网络与办公网络、大屏控制网络必须物理彻底隔离。应急链路严禁承载文件传输等大流量任务,仅限追踪数据与控制指令的极简数据交换。
- 人员冷备预案 在关键直播任务中,安排一名“备份操作员”。这位备份人员不干活,只负责盯着主机的 Stats Unit 面板。一旦发现 GPU 负载长期飙升至 95% 或内存泄漏持续增长,立即提前启动预备切换逻辑。
五、 总结
在虚拟制片的竞技场里,系统的强大与否不仅在于它能跑多复杂的效果,更在于它在濒临崩溃时展现出的从容与韧性。通过构建硬件冗余、镜像算力与一键恢复的应急架构,你将虚拟制片的可靠性从“看天吃饭”提升到了“工业化保障”的高度。
记住,直播是没有撤回键的。预先构建应急架构不是对技术的怀疑,而是对观众最大的尊重。当所有的容灾回路都在暗处默默运转,当系统宕机的那一刻,观众依然在享受完美流畅的画面——那一刻,才是你作为虚拟制片技术架构师真正的尊严时刻。
 简体中文
 English